案例类别:人工智能+跨学科融合
课程名称:计算机辅助药物设计 适用专业:制药工程、药物制剂、药物分析
开课学院:药学院 主讲教师:马少杰
技术类型:深度学习、图神经网络、大型语言模型、蛋白质结构预测模型
应用场景:药物研发中的靶点-化合物相互作用预测与虚拟筛选
案例简介
本案例聚焦于人工智能(AI)在药物发现领域的革命性应用,以解决传统大型语言模型(LLMs)在该领域面临的“幻觉”和结构信息缺失等核心痛点。案例详细剖析了一个名为“Llama-Gram”的前沿AI药物设计框架。该框架创造性地将蛋白质折叠信息(通过ESMFold模型)、化合物的图结构数据(通过Transformer)以及不确定性评估(通过Gram层)整合到一个端到端的深度学习模型中。通过对Llama-Gram模型的设计原理、实施流程、性能评估以及在两个真实世界药物发现项目(靶点为中心的抑制剂发现和化合物为中心的靶点鉴定)中的成功应用进行深入探讨,本案例旨在帮助学生理解AI如何基于“结构决定性质”的化学第一性原理,实现对药物-靶点相互作用的高精度预测,从而加速创新药物的研发进程。
一、背景
1.传统药物研发的困境与AI的兴起
传统的新药研发是一个耗时漫长(平均超过10年)、成本高昂(超过10亿美元)且成功率极低的过程。其中,从海量化合物中筛选出对特定疾病靶点有效的“苗头化合物”是关键的第一步。传统的高通量筛选(HTS)方法虽然有效,但成本巨大且通量有限。分子对接等计算方法虽然降低了成本,但其精度和速度仍受限于打分函数的准确性和对蛋白质柔性的处理能力,难以满足日益增长的研发需求。
近年来,以深度学习为代表的人工智能技术为药物发现带来了曙光。特别是大型语言模型(LLMs),如GPT和Llama,在处理序列数据方面展现出强大能力,被尝试用于预测药物-靶点相互作用(Compound-Protein Interaction, CPI)。
2. AI药物设计面临的核心痛点:“幻觉”与信息缺失
尽管前景广阔,但将通用LLMs直接应用于精准的药物设计领域仍面临严峻挑战:
(1)“幻觉”(Hallucination)问题
“幻觉”是指模型生成了看似合理但与事实不符或缺乏数据支持的预测。在药物设计中,这意味着模型可能错误地预测一个无效的分子具有高活性,这将导致后续实验资源的巨大浪费,是AI制药领域必须解决的致命缺陷。
(2)关键三维结构信息的丢失
蛋白质的功能由其精确的三维空间结构决定,尤其是与药物结合的“口袋”区域。然而,传统LLMs主要处理一维的氨基酸序列,无法直接捕捉和理解决定其功能的蛋白质折叠信息。这种关键信息的丢失,极大地限制了模型预测的准确性。
(3)分子图结构处理的局限性
与线性的文本序列不同,药物小分子本质上是图结构(原子为节点,化学键为边)。传统LLMs不擅长处理这种非欧几里得空间数据,难以充分捕捉分子的拓扑结构、化学基团及其空间排布,从而影响对分子性质的理解。
因此,开发一种能够同时整合蛋白质三维结构信息、理解分子图结构、并能评估自身预测可靠性的新型AI框架,成为推动AI制药发展的迫切需求。本案例所介绍的Llama-Gram模型,正是为了解决以上核心痛点而设计的针对性突破方案。
二、案例实施情况
本案例的核心是Llama-Gram模型,它是一个基于“蛋白质折叠”的端到端药物设计框架(图1)。其整体实施流程可分为模型构建、训练评估和应用验证三个阶段。
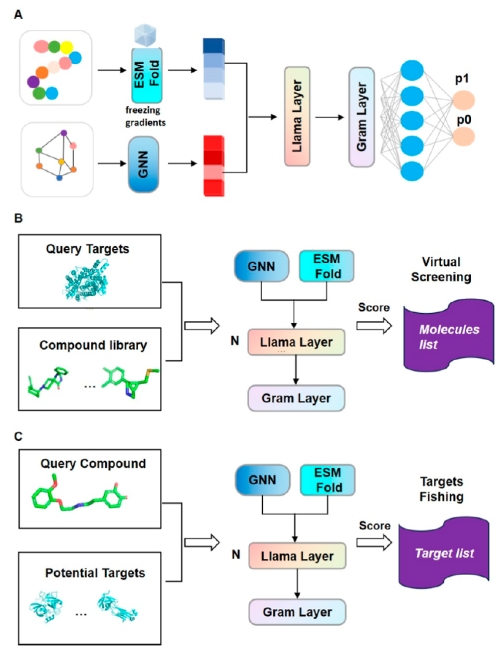
图1 Llama-Gram 模型的架构及方法流程
(A)Llama-Gram 模型的架构;(B) 使用 Llama-Gram 模型进行靶点推断的流程,查询靶点是指对研究人员感兴趣的靶点进行虚拟筛选;(C) 使用 Llama-Gram 模型识别新型活性化合物的流程。
1. Llama-Gram模型的创新架构
Llama-Gram的设计思想是将两种不同模态的数据——蛋白质(序列+折叠结构)和化合物(图结构)——进行高效编码和特征融合,最终输出精准的相互作用预测和可靠性评估。
· 蛋白质处理模块:
o 输入:蛋白质的氨基酸序列。
o 技术:采用Google DeepMind开发的ESMFold模型。这是一个高精度的蛋白质结构预测模型。在本框架中,研究者巧妙地“冻结”了ESMFold的梯度,仅将其作为一个特征提取器,高效地将一维氨基酸序列转换为富含三维空间折叠信息的嵌入向量(Embedding)。这相当于让模型“看懂”了蛋白质的结构。
· 化合物处理模块:
o 输入:化合物的SMILES表示式,并转换为图结构。
o 技术:使用一种图Transformer(Graph Transformer)的变体。该模块首先通过图卷积网络(GCN)捕捉原子及其邻近化学环境的局部特征,然后利用多头自注意力机制(Multi-head Self-attention)学习分子中远距离原子间的相互关系,生成能够全面反映分子结构的原子嵌入向量。
· 特征融合与解码模块(Llama Layer):
o 输入:蛋白质的结构嵌入向量和化合物的原子嵌入向量。
o 技术:该模块基于强大的Llama解码器架构。研究者对其进行了优化,采用分组查询注意力(Grouped-Query Attention, GQA)机制,在保证模型性能的同时,大幅提升了计算效率。该层负责深度融合蛋白质和化合物的特征,学习它们之间复杂的相互作用模式。
· 输出与不确定性评估模块(Gram Layer):
o 输入:Llama层输出的融合特征。
o 技术:这是模型的关键创新之一。该层基于支持点理论(Support Points Theory),而非传统的Softmax函数。它不仅能计算出两者结合的概率(即Llama-Gram Score),还能通过计算不同类别(结合/不结合)支持点的差异(Δs),来量化模型预测的置信度。Δs值越大,表示模型对预测结果越“自信”,从而有效识别并过滤掉可能是“幻觉”的低置信度预测。
2. 模型的训练与性能评估
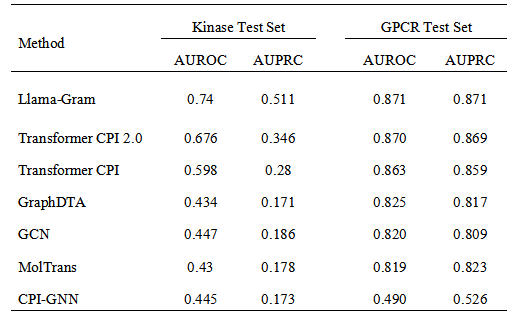
· 数据集:模型首先在经典的ChEMBL 23数据集上进行训练,并与其他先进模型在同一个测试集上进行公平比较。为了提升模型的泛化能力,研究团队还构建了一个包含超过250万个数据点的大规模、高质量、去冗余的新数据集CPI-P,用于模型的最终训练。
· 性能对比: 如表1所示,Llama-Gram在AUROC和AUPRC两项关键指标上均显著超越了包括TransformerCPI 2.0、GraphDTA在内的多个主流模型,证明了其卓越的预测精度。
表1 Llama-Gram 等模型在激酶和 GPCR 测试集上的表现
· 虚拟筛选能力验证:在模拟真实药物筛选场景的DUD-E和DEKOIS 2.0数据集上,Llama-Gram的富集因子(Enrichment Factor, EF)远高于Glide、AutoDock Vina等经典的分子对接软件。这意味着在筛选前1%的化合物时,Llama-Gram能找到更多真正的活性分子,效率更高。
3. 真实世界应用验证
(1)案例一:为阿尔茨海默病(AD)发现可入脑的新型抑制剂
· 目标:AD的关键致病蛋白Galectin-3,其现有抑制剂多为糖苷衍生物,极性太强,无法穿过血脑屏障(BBB)进入大脑发挥作用。
· 实施:
1.利用训练好的Llama-Gram模型对一个包含160万个化合物的内部库进行虚拟筛选。
2. 结合另一个GNN模型预测化合物的BBB渗透性,筛选出Llama-Gram评分高且可能入脑的分子。
3.通过化学多样性聚类,最终挑选40个代表性化合物进行实验验证。
· 成果:成功发现了一个名为AI-1887的全新骨架疏水性分子。实验证实,它对Galectin-3具有中等强度的结合能力(Kd = 7.734 µM),并能在细胞水平上有效抑制炎症反应(IC50 = 4.36 µM)。这一成功案例展示了Llama-Gram在“以靶点为中心”的药物发现中的巨大潜力(图2)。
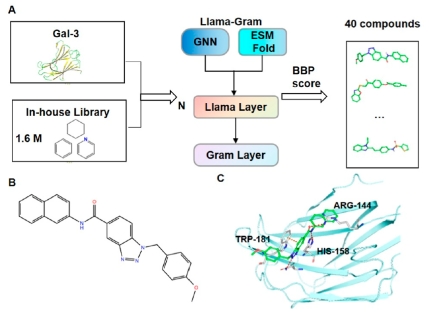
图2 新型疏水性Gal-3抑制剂AI-1887的研发
(A) 新型疏水性Gal-3抑制剂的筛选流程;(B) AI-1887的化学结构和理化性质;(C) AI-1887与Gal-3的结合构象 (PDB: 8ITZ)。
(2)案例二:揭示天然产物的神秘靶点
· 目标:一种名为Eucarbwenstols D(R14)的天然产物显示出良好的肾脏保护活性,但其作用靶点未知。
· 实施:
1. 首先使用传统的CMap分析初步预测了11个可能的靶点。
2. 利用Llama-Gram对这11个靶点与R14的相互作用进行精准打分和排序。
· 成果: Llama-Gram模型以最高分明确指向了EGFR(表皮生长因子受体)。随后的体外酶活性实验证实,R14确实是一种强效的EGFR抑制剂(IC50 = 191.1 nM)。该案例展示了Llama-Gram在“以化合物为中心”的靶点发现中的精准预测能力。
三、案例创新突破
(一)主要创新内容
· 融合化学第一性原理的端到端设计:首次将“蛋白质折叠”这一决定功能的结构基础信息,通过ESMFold模型无缝整合进一个端到端的CPI预测框架中,使模型的预测更符合生物化学原理。
· 多模态数据处理的统一框架:成功地在一个统一的架构下,同时处理了代表蛋白质结构信息的高维嵌入向量和代表化合物拓扑结构的图数据,实现了跨模态信息的深度融合。
· 引入不确定性评估以对抗“幻觉”:独创性地设计了基于支持点理论的Gram层,使模型具备了“自知之明”,能够量化预测结果的置信度,这对于在实际应用中过滤不可靠预测、节约实验资源具有至关重要的意义。
(二)技术突破内容
本案例的核心技术突破在于构建了一个能够进行不确定性量化的、基于蛋白质折叠原理的图-文多模态深度学习模型。它突破了传统CPI模型仅依赖序列信息或需要精确实验结构的限制,也突破了通用LLMs无法有效处理结构化数据和存在“幻觉”问题的瓶颈。该技术在AI制药领域处于前沿水平,为开发更可靠、更精准的AI药物设计工具提供了全新的思路和技术路径。
(三)应用实践突破内容
本案例在应用实践上实现了两大突破:
· 实现了高难度靶点抑制剂的“从零发现”:针对Galectin-3这一靶点,成功发现了现有抑制剂化学类型之外的、具有全新骨架和更优成药性质(可入脑)的苗头化合物,展示了AI发现真正意义上“创新”分子的能力。
· 实现了对复杂天然产物靶点的精准预测:天然产物结构复杂、作用机制多样,其靶点鉴定一直是药学研究的难点。本案例成功精准预测并验证了R14的靶点,展示了该模型在反向药理学研究中的巨大应用价值。
对于人才培养而言,本案例能够帮助学生建立起将前沿AI技术与药物研发实际需求相结合的“计算思维”和“系统思维”,理解如何将抽象的算法模型应用于解决具体的科学问题,培养其成为具备跨学科知识背景的复合型创新人才。
四、推广价值
本案例所展示的Llama-Gram框架具有巨大的推广价值和广阔的应用前景:
• 加速药物发现进程:该模型可以作为一个高效、可靠的虚拟筛选平台,快速从数百万甚至数十亿规模的化合物库中发现潜在的活性分子,从而大幅缩短药物研发早期的先导化合物发现周期。
• 降低研发成本与风险:通过高精度的预测和不确定性评估,可以优先合成和测试那些最有可能成功的候选化合物,避免在低潜力分子上浪费时间和金钱,从而降低新药研发的失败风险。
• 赋能个性化药物与“老药新用”:该模型不仅可以用于发现新药,还可以用于系统性地评估已知药物与多种疾病靶点的相互作用,为“老药新用”提供科学依据。同时,也可以针对特定基因突变的靶点蛋白,设计个性化的治疗药物。
• 示范引领作用:Llama-Gram作为一个成功范例,为后续的AI药物设计研究提供了重要的借鉴。其融合多模态信息、关注模型可解释性与可靠性的设计理念,将引领该领域向着更精准、更可靠、更实用的方向发展。目前,该模型已经成功应用于两个实际项目中并取得了突破性成果,展示了其从理论到实践的转化能力。
五、其他相关情况
(一)案例获奖情况
无
(二)第三方评价
• 专家评审意见:该研究发表于国际顶级药物化学期刊《Journal of Medicinal Chemistry》(中科院一区TOP期刊,本案例撰写人为通讯作者),表明其创新性和科学价值得到了该领域权威专家的认可。
• 同行引用与评价:该模型的设计理念,特别是其对蛋白质折叠信息和不确定性的处理方式,为AI制药领域的研究者提供了新的视角。
(三)案例相关数字资料。为支持教学活动,提供与案例相关的正式发表论文及支撑材料。

