案例类别:人工智能+专业课程
课程名称:计算机辅助药物设计 适用专业:药学相关专业
开课学院:药学院 主讲教师:司鑫鑫
技术类型:深度学习
应用场景:新药研发中基于特定靶点筛选潜在活性化合物
案例简介
DYRK1A(双特异性酪氨酸磷酸化调节激酶1A)是重要的药物设计靶点,其异常表达或过度激活与多种疾病密切相关,针对DYRK1A的干预策略具有广泛的治疗潜力。本案例构建了基于深度神经网络(deep neural network,DNN)的DYRK1A抑制剂预测模型,为筛选DYRK1A抑制剂提供计算工具。首先,从ChEMBL数据库中收集了DYRK1A抑制剂和非抑制剂共927个,通过随机采样10次建立了10组训练集和测试集,并计算出每个化合物的2种不同的分子特征,即MACCS指纹和Morgan2指纹,采用深度神经网络算法建立了20个模型,通过比较研究确定其中性能最佳的模型,并且对模型进行了Y-随机化检验、应用域和相似度图分析。结果:基于第2对训练-测试集Morgan2指纹的DNN模型(DNN1_Morgan2)性能最佳,对测试集内化合物的分类准确度为0.821,马修斯相关系数和ROC曲线下面积分别为0.647和0.917。此最优模型可用于DYRK1A抑制剂的活性预测、虚拟筛选,并用于先导化合物的设计及优化。
一、背景
双底物特异性酪氨酸磷酸化调节激酶1A(DYRK1A)是保守DYRK家族激酶之一,参与pre-mRNA的选择性剪接、胚胎神经发生、细胞存活、细胞分化等多种生物功能,其过表达还与唐氏综合症、神经退行性疾病、肿瘤及糖尿病等多种疾病密切相关。到目前为止,还未有DYRK1A抑制剂批准上市,因此DYRK1A抑制剂的研究与开发具有广阔的市场前景。DYRK1A抑制剂主要来源于已知激酶抑制剂的结构改造或者高通量筛选等实验手段,这些方式有着耗时长、成本高等缺点。由于虚拟筛选是快速高效发现活性化合物的有效手段,近年来,虚拟筛选被应用于DYRK1A抑制剂的筛选。然而,尚未见报道可用于筛选DYRK1A抑制剂的机器学习模型。鉴于此,本研究通过建立基于机器学习的DYRK1A抑制剂预测模型,旨在为DYRK1A抑制剂活性预测、虚拟筛选、先导化合物的设计与优化提供计算工具。
二、案例实施情况
1. 用于建模与评价的数据集
1.1 数据收集和整理
从ChEMBL 29数据库中下载标注有IC50值的DYRK1A化学生物学数据1161条,提取有明确IC50值的化合物数据,按以下方式进行数据预处理。用RDKit(版本2019.9.3)中Salt Remover模块去盐,再用MolVS(版本0.1.1,https://github.com/ mcs07/MolVS)中Uncharger和standardize_smiles模块对简化分子线性输入规范(simplified molecular input line entry specification,SMILES)进行电性中和以及标准化。对于通过不同生物测定方法确定的具有多个IC50值的化合物,将IC50平均值作为其最终IC50值。根据类药性(drug-likeness)原则,去除可旋转键的数量超过20个或分子量超过600的化合物。定义生物活性值在1μM以下的化合物为抑制剂,其他的化合物为非抑制剂。为实现正负样本数据的平衡(balanced data),将DYRK1A化学生物学数据中没有明确IC50值,但标注有数值大于1μM且不与以上化合物重复的结构也作为非抑制剂,增加非抑制剂数量。
1.2 数据集的描述
首先,对数据集进行主成分分析(principal component analysis,PCA)。根据SMILES式,利用分子描述符计算软件Mordred,计算了训练集和测试集中有明确IC50值的化合物的分子描述符。每个化合物可分别生成43组共计1613个可定量表示化合物的理化性质和拓扑性质的二维描述符。计算所有分子Mordred描述符之后,删除所有值为空值、0或小于0.05的描述符。剩余描述符通过皮尔逊(Pearson)相关系数(correlation coefficient,CC)分析和递归特征消除(recursive feature elimination, RFE)进行特征选择。
具体步骤包括:①计算IC50值与每个描述符的Pearson CC值。Pearson CC值小于0.05的描述符因与IC50值无显著相关性而被舍弃,保留Pearson CC值不低于0.05的描述符。②根据Pearson CC值按降序排列剩余的描述符,依次确定排名靠前的描述符和所有排名靠后的描述符之间的Pearson CC值,若两者之间Pearson CC值大于0.95,说明后者与前者高度相关,删除排名靠后的描述符。③基于10倍交叉验证对描述符进行RFE。通过上述步骤,最终选择了16种Mordred描述符(见表1)。基于挑选的Mordred描述符对整个数据集内的化合物进行主成分分析。
表1 通过特征选择确定Mordred描述符
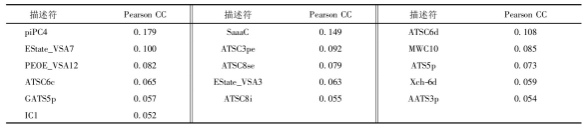
其次,对数据集内的分子进行结构多样性分析。根据Morgan2指纹计算出每对化合物间的Tanimoto系数(Tanimoto coefficient,Tc),该系数用于衡量两两结构之间的相似度,通过Tc分布曲线判定数据集内分子的多样性情况。
1.3 结果
DYRK1A数据集含有927个化合物,其中抑制剂430个,非抑制剂497个。基于16种Mordred描述符的PCA分析展示的化学空间(见图1A),结果显示DYRK1A抑制剂和非抑制剂在化学空间上存在大量重叠,同时两者占据了一个独特的化学空间。根据Morgan2指纹计算出的Tc值分布曲线(见图1B),结果显示,大多数化合物间的相似度值小于0.3,说明DYRK1A数据集内的化学结构具有多样性。
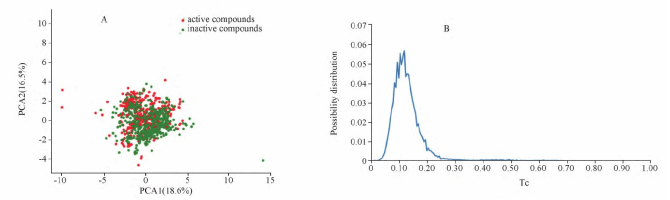
图1 DYRK1A数据集的表征
注:A:抑制剂和非抑制剂的化学空间;B:基于Morgan2指纹的拓扑相似度分布(Tanimoto系数,Tc)
2. 模型性能及最优模型选择
2.1分子特征生成
利用RDKit计算MACCS指纹(166位)和Morgan2指纹(1024位)对分子进行表征。
2.2模型构建和评估
从DYRK1A数据集中随机取80%数据作为训练集,另外20%作为测试集。随机采样10次,获得10对训练集和测试集。基于10对数据集,采用Keras的深度神经网络(deep neural network,DNN)算法训练和验证模型。本案例所采用的DNN是由输入层、输出层和2个隐含层组成的全连接神经网络。2个隐含层分别由512个神经元所组成,激活函数为“ReLU”函数;输出层由1个神经元组成,激活函数为“Sigmoid”函数。模型以Adam为优化算法,二分类交叉熵(binary cross entropy)为损失函数。
DNN模型训练以训练集为基础,以预测准确度(accuracy,AC)为目标,采用网格搜索方法进行超参数优化,并通过10倍交叉验证确定最优参数。在本研究中,超参数的设置范围如下:批量大小(batch size)范围为128、256、512;无效神经元的比例(dropout rate)范围设置为0.1、0.2、0.3;学习率(learning rate)范围设置为0.01、0.001、0.0001。
模型评价以测试集为基础,通过AC、灵敏度(sensitivity,SE)、特异性(specificity,SP)、马修斯相关系数(Matthews correlation coefficient,MCC)和ROC曲线下面积(area under the curve,AUC)对模型性能进行评价。SE是预测正确的阳性样本在所有阳性样本中所占的百分比,SP是预测正确的阴性样本在所有阴性样本中所占的比例。MCC是一个平衡的衡量指标,包含了真阳性(true positive,TP)、真阴性(true negative,TN)、假阳性(false positive,FP)和假阴性(false negative,FN)。AUC表示随机选择的阳性样本比随机选择的阴性样本排名高的概率。通过不断调整机器学习中分类器的阈值,得到不同的真阳性率(true positive rate,TPR)和假阳性率(false positive rate,FPR)数值,根据TPR与FPR的比值绘制ROC曲线,计算其AUC值。AUC值越高,说明分类器对阳性类别的排序效果越好。具体定义如下:
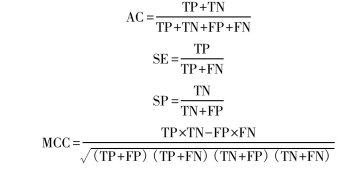
上述公式中,TP表示活性化合物的数量。TN表示非活性化合物的数量。FP是指非活性化合物被归类为活性化合物的数量。FN是指被归类为非活性的活性分子的数量。
2.3应用域(applicability domain)研究
首先,基于Morgan2指纹计算测试集中每个化合物与训练集中任意化合物的Tc值,每次运行自动设置Tc阈值以逐步去除相似化合物。具体如下:在第一次运行中设置Tc阈值为1.0,在后续的每次运行中Tc阈值下降0.02,在最后一次运行中设为0.5。如果测试集中的化合物所有Tc值都小于阈值,那么将它保留。通过这种方式,每次生成测试集的一个子集(即测试子集),以AUC指标评估最佳模型的性能。
2.4结果
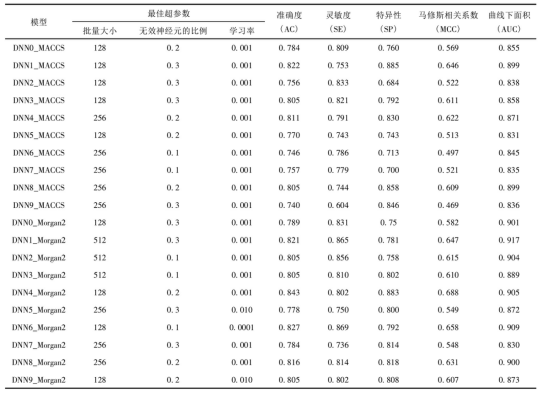
各模型在测试集上的性能指标如表2所示,ROC曲线如图2所示。表2所示,各模型在测试集上的AC值为0.740~0.843,MCC值为0.469~0.688,AUC值为0.830~0.917。对于不同的分子特征,基于Morgan2指纹构建的模型性能优于MACCS指纹,基于Morgan2指纹的模型平均AUC为0.892,平均MCC为0.613,基于MACCS指纹的模型平均AUC为0.835,平均MCC为0.558。上述数据表明,在两个分子特征中,基于Morgan2指纹建立的DNN模型更好。根据表2中列出的AUC值,表明基于第2对(以DNN0为起始编号,DNN1为第2对)训练-测试集Morgan2指纹的DNN模型DNN1_Morgan2模型表现最好,其超参数为:批量大小为512,无效神经元的比例为0.3,学习率为0.001;模型的AC为0.821,SE为0.865,SP为0.781,MCC值为0.647,AUC值为0.917。
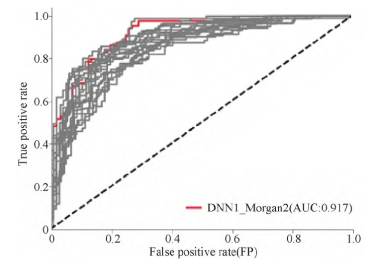
图2 基于MACCS指纹和Morgan2指纹的DNN模型的ROC曲线(注:红色曲线为最佳模型DNN1_Morgan2的ROC曲线)
表2 各模型在测试集上的性能指标和超参数
3. DNN1_Morgan2模型
3.1 Y-随机化检验
Y-随机化检验(Y-randomization test)用于验证最优模型的鲁棒性。本研究共进行了3次Y-随机化检验。在每次Y-随机化测试中,在保持特征数据不变的情况下,通过随机打乱生物活性标签(即活性或非活性)生成一个新的训练集。在此基础上,采用与原模型相同的超参数搜索空间和方法重新训练模型。得到的模型在没有进行Y-随机化的测试集上进行评估。如果新模型的性能远不如基于原始训练集的分类模型,那么在原始训练集上训练的分类模型的性能就不是偶然的。
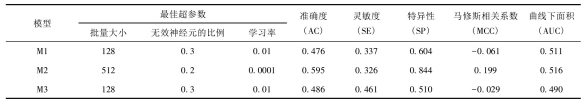
如表3所示,M1、M2和M3是经过Y-随机化检验、基于Morgan2指纹的3个DNN模型。经过Y-随机化检验,3个模型的AUC值分别为0.511、0.516和0.490,MCC值分别为-0.061、0.199和-0.029。AUC和MCC值极低,说明所构建的模型无法准确识别DYRK1A抑制剂。因此,本研究建立的最佳模型DNN1_Morgan2的预测性能不是偶然的。
表3 经过Y-随机化检验的3个模型的性能指标和超参数设置
3.2 相似度图
相似度图(similarity map):由RDKit根据Riniker等提出的方法基于最佳模型生成相似度图。在相似度图中,通过计算原子被移除前后的预测分子的活性概率之差以表示原子对于生物活性的贡献,并将其可视化。
如图3显示了2个代表性DYRK1A抑制剂和2个代表性非DYRK1A抑制剂的相似度图。在相似度图中,绿色部分表示对生物活性有贡献的片段,而粉色部分表示该原子可能使化合物失去活性。根据已知的DYRK1A抑制剂的构效关系,芳杂环结构常出现在DYRK1A抑制剂中,而非DYRK1A抑制剂没有相同特征。如图3显示的结果较为一致,说明DNN1_Morgan2模型可以识别影响DYRK1A抑制活性的分子片段。
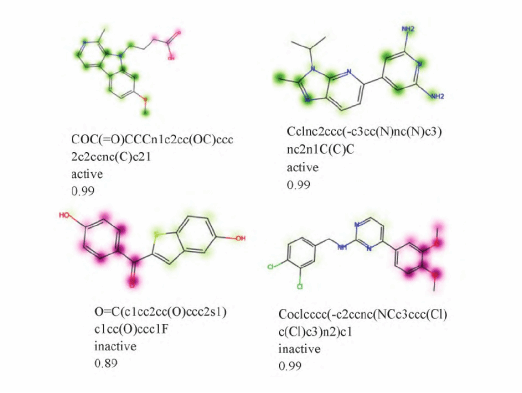
图3 DYRK1A测试集1中4种代表性化合物的相似度图(注:SMILES、生物活性类别标签和DNN1_Morgan2模型预测的概率)
3.3 适用域
首先,基于Morgan2指纹计算测试集中每个化合物与训练集中任意化合物的Tc值,每次运行自动设置Tc阈值以逐步去除相似化合物。具体如下:在第一次运行中设置Tc阈值为1.0,在后续的每次运行中Tc阈值下降0.02,在最后一次运行中设为0.5。如果测试集中的化合物所有Tc值都小于阈值,那么将它保留。通过这种方式,每次生成测试集的一个子集(即测试子集),以AUC指标评估最佳模型的性能。
测试子集的AUC值随着Tc阈值的减小而减小。如图4所示,对于最大Tc在0.70~1.0之间的测试子集,AUC值均大于0.80。当阈值下降到0.70以下时,AUC开始显著下降。对于最大相似度为0.5的测试子集,AUC值低至0.416。因此,为了保证DYRK1A化合物的准确分类,预测的化合物与用于模型训练的化合物之间的Tc值应大于0.70。
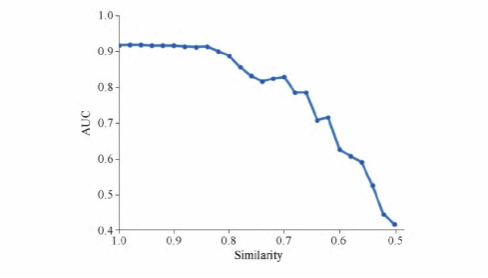
图4 DNN1_Morgan2模型的ROC AUC值随训练化合物与测试化合物之间最大结构相似度而变化的曲线
4. 小结
本案例建立了包含927个化合物的DYRK1A数据集,并通过随机采样建立了10对训练集和测试集,在此基础上,分别运用MACCS指纹和Morgan2指纹对化合物进行表征,采用DNN算法建立了20个模型,并评估了模型性能,确定了一个性能最好的模型DNN1_Morgan2。为了充分验证DNN1_Morgan2模型,本研究还进行了Y-随机化检验,绘制了相似度图,并利用测试集分析了其适用域,表明该模型的预测性能不是偶然的,它可以识别影响DYRK1A抑制活性的重要片段。当化合物与用于模型训练的化合物之间的结构相似度(Tc值)大于0.70时,预测效果较好。鉴于该模型的良好性能,该模型可应用于DYRK1A抑制剂的筛选,辅助DYRK1A抑制剂的发现与设计。
三、案例创新突破
(一)主要创新内容。重点介绍对应案例类型的创新情况。
(1)多特征融合与模型优化策略
将MACCS指纹与Morgan2指纹两种分子描述符结合,构建了DNN模型的多维度特征空间。MACCS指纹捕捉分子官能团和结构片段特征,而Morgan2指纹(半径2的环形指纹)更擅长表征局部化学环境,二者的融合显著提升模型对DYRK1A抑制剂关键药效基团(如噻唑烷酮基团、芳香环)的识别能力。通过随机采样生成10组训练集/测试集,并采用Y-随机化检验验证模型可靠性,突破了传统单一特征建模的局限性
(2)教学与科研的闭环设计
案例将科研项目(DYRK1A抑制剂开发)转化为教学模块,通过“理论-案例-实操”三阶段教学,使学生掌握从靶点分析到虚拟筛选的全流程,强化了科研反哺教学的理念。
(二)应用实践突破内容。实现了在哪些应用实践的突破,对人才培养的意义与价值。
(1)高效虚拟筛选与先导化合物发现
本案例构建了预测潜在DYRK1A抑制剂的DNN模型。从公共数据库中筛选出一个包含已知DYRK1A生物活性的化合物的数据集,并将其分为训练集和测试集,用于模型训练和评估。分别运用MACCS指纹和Morgan2指纹对化合物进行表征,采用DNN算法建立了20个模型,并评估了模型性能,确定了一个性能最好的模型DNN1_Morgan2。该模型性能良好,可应用于DYRK1A抑制剂的筛选,辅助DYRK1A抑制剂的发现与设计。
(2)对人才培养的意义:1)知识体系构建,科研思维训练:学生系统掌握多模态特征、深度学习模型调优及虚拟筛选全流程,形成“靶点机制-数据建模-实验验证”的闭环思维。2)技术交叉融合,实践能力提升:将药物设计实验操作引入到课程,理论与实践结合。案例融合计算化学(分子描述符)、生物学(激酶作用机制)与计算机科学(深度学习),培养多技术协同创新能力的复合型科研人才。通过案例实操,学生能独立完成药物设计全流程,适应AI辅助药物研发的产业需求。
四、推广价值
1.技术方法的跨靶点适用性
本案例构建的DNN模型基于分子指纹(MACCS/Morgan2)和多特征融合策略,可推广至其他激酶(如CDK、ALK)或神经退行性疾病靶点(如Tau激酶)的抑制剂预测。例如:同类激酶扩展:DYRK家族激酶(DYRK1B、DYRK2)与DYRK1A具有相似的ATP结合口袋,模型可
2.科研反哺教学的双重价值
案例将DYRK1A抑制剂开发流程转化为教学模块,学生可掌握从数据清洗、模型训练到实验验证的全链条技能,适配高校《计算机辅助药物设计》课程建设需求。
五、其他相关情况
案例发表论文3篇:
[1]王亚铃,钱晨亮,姚明丽,司鑫鑫*,夏杰*.基于深度神经网络的DYRK1A抑制剂预测模型研究[J].中国医药导刊,2022,24(07):672-677.
[2] Si, X., Qian, C., Qiu, N., Wang, Y., Yao, M., Wang, H., Zhang, X., & Xia, J. (2025).Discovery of a novel DYRK1A inhibitor with neuroprotective activity by virtual screening and in vitro biological evaluation. Molecular diversity, 29(1), 337–350.
[3] Si, X., Wang, Y., Qiu, N., Qian, C., Yang, B., Jin, H., Wang, H., Zhang, X., & Xia, J.(2025). Computer-aided discovery of triazolothiadiazoles as DYRK1A-targeted neuroprotective agents. RSC medicinal chemistry, 10.1039/d5md00289c. Advance online publication.

